Des chercheurs présentent la lecture et l’écriture de poids neuronaux par un LLM
Dans « Sparks of Weight-Space Programming », publié le 2 novembre 2026, des chercheurs du MIT présentent des expériences de lecture et de modification directe de poids neuronaux par un grand modèle de langage. Une contre-analyse nuance la portée des gains annoncés.
Ce qui est nouveau
Rikiya Takehi, Jayden Teoh, Alex Zhang et Omar Khattab, affiliés au laboratoire d’informatique et d’intelligence artificielle du MIT, présentent des expériences où un grand modèle de langage (LLM) interprète ou modifie les paramètres numériques d’autres réseaux neuronaux : leurs « poids ».
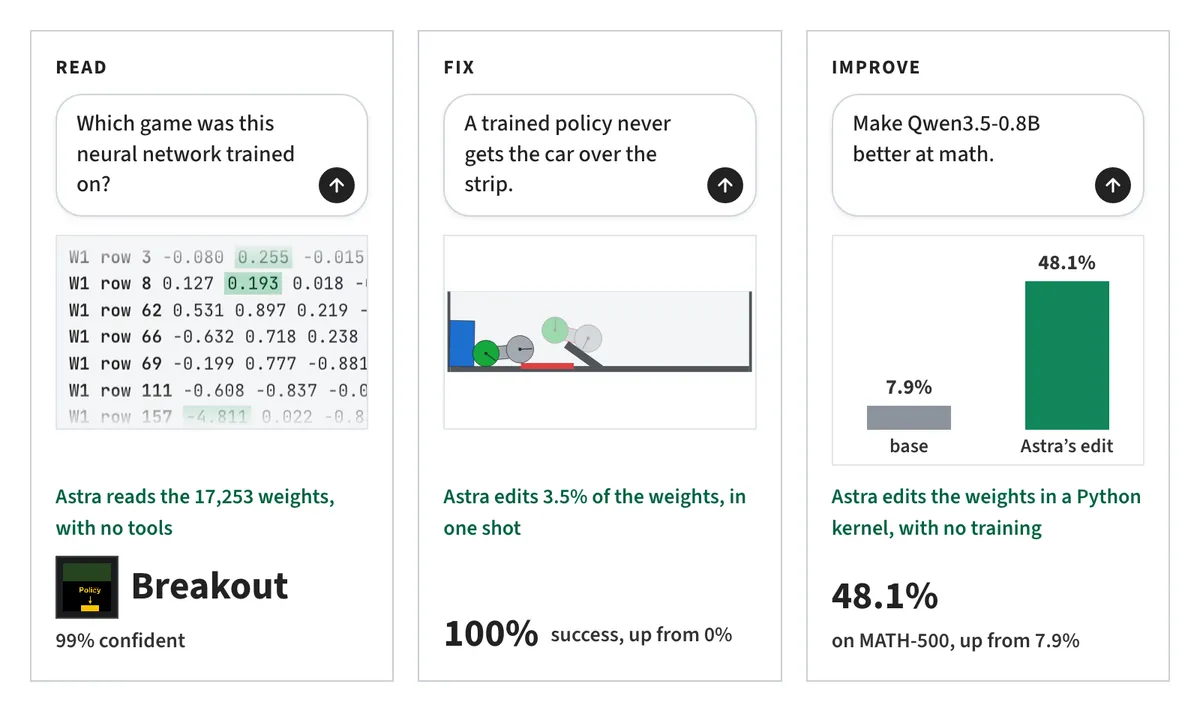
Leur publication, datée du 2 novembre 2026, appelle cette approche Weight-Space Programming. Le modèle, désigné par les auteurs comme GPT-6 Astra d’OpenAI, est notamment chargé d’identifier le jeu appris par un réseau à partir de ses poids, de réparer un réseau de contrôle et d’écrire des réseaux de jeu. Les auteurs publient les journaux des expériences et les modifications finales dans un dépôt GitHub.
Ce qui change et pourquoi
L’approche ne consiste pas à demander au LLM d’écrire un programme d’entraînement. Il reçoit un objectif en langage naturel et intervient directement sur les poids, sans descente de gradient, le mécanisme habituel d’ajustement des paramètres pendant l’apprentissage. Certaines expériences se déroulent sans outil ; d’autres autorisent du code Python exécuté dans un environnement isolé, dont les résultats sont renvoyés au modèle.
Sur Qwen3.5-0.8B, les auteurs rapportent une modification ciblant des boucles de raisonnement. Ils annoncent un passage de 7,9 % à 48,1 % sur l’évaluation mathématique MATH-500, à réglages de génération identiques.
La contre-analyse de Carlos Toledo confirme l’existence de la modification, mais nuance cette comparaison. Il rapporte que le modèle initial atteint 44,0 % avec les réglages sans raisonnement recommandés par Qwen. Selon son analyse, le gain observé tient surtout à une meilleure terminaison des réponses et dépend fortement des réglages retenus.
Pourquoi c’est important
Ces expériences explorent une autre manière d’interpréter et de modifier les réseaux : confier au LLM une intervention sur leurs paramètres plutôt que sur leur seul code d’entraînement. Elles ne démontrent pas encore une méthode générale d’amélioration des modèles.
Le dépôt ne contient que les essais rapportés dans la publication, à l’exclusion des essais de versions antérieures des consignes. La généralisation des résultats reste donc à établir ; les scores annoncés ne suffisent pas à démontrer une progression équivalente des capacités de raisonnement.
Sources
Sélection et relecture humaines, rédaction assistée par IA.