Claude Fable 5.2 prend la tête de l’indice d’Artificial Analysis avec 65 points
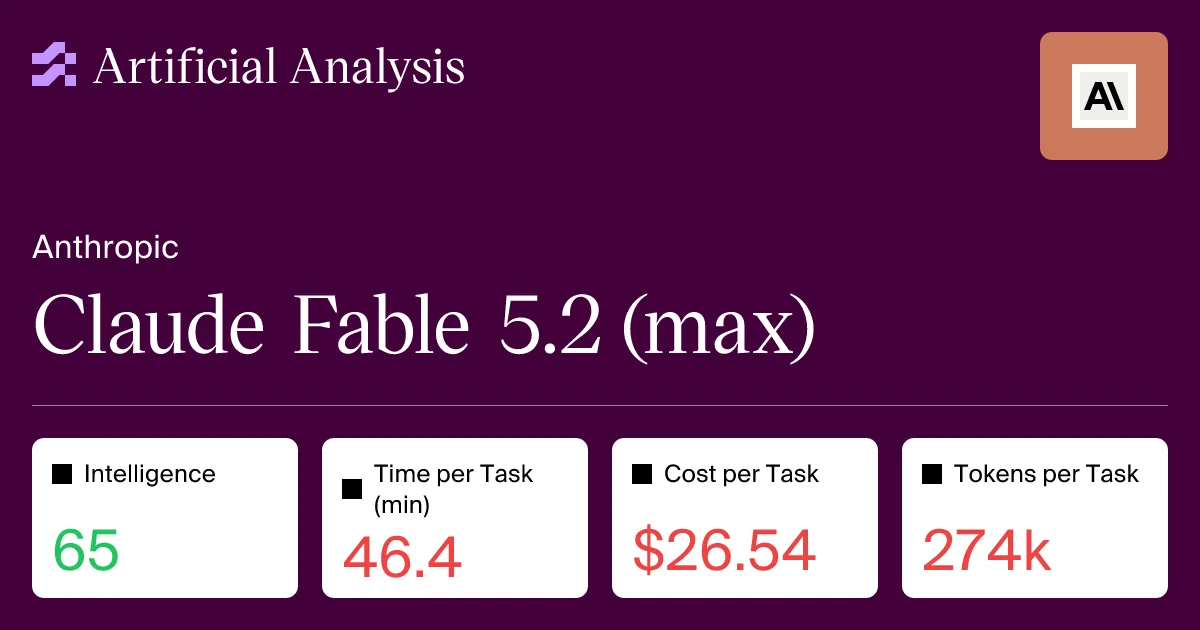
Lancé par Anthropic le 9 novembre 2026, Claude Fable 5.2 obtient 65 points à l’Intelligence Index d’Artificial Analysis. La configuration évaluée arrive première parmi 74 modèles, mais se distingue aussi par un temps de traitement élevé.
Ce qui est nouveau
Claude Fable 5.2 atteint 65 points à l’Artificial Analysis Intelligence Index, dans sa version v5.0.1. Artificial Analysis classe la configuration « Max, Default Fallback » première parmi 74 modèles. Ce résultat établit sa position en tête du classement affiché, sans démontrer à lui seul un record historique toutes versions de l’indice confondues.
Anthropic a annoncé le modèle le 9 novembre 2026, avec Claude Mythos 5.2. Les deux reposent sur le même modèle sous-jacent. Fable intègre des protections contre les usages abusifs en cybersécurité et en biologie ; l’accès à Mythos passe par les programmes de vérification d’Anthropic.
Ce qui change et pourquoi
L’indice agrège neuf évaluations réparties entre travail intellectuel, programmation, sciences et connaissances générales. Chacune de ces quatre catégories pèse 25 % du résultat. Il mesure donc un ensemble de capacités, et non la seule programmation ou la vitesse de réponse.
Anthropic annonce des progrès en programmation, en raisonnement et en vision par rapport aux versions précédentes. L’éditeur indique aussi une génération de texte jusqu’à 30 % plus rapide que celle de Fable 5.1. Cette mesure ne se confond pas avec la durée nécessaire pour résoudre une tâche complète.
Dans les tests d’Artificial Analysis, Fable 5.2 prend en moyenne 46,4 minutes par tâche, contre une médiane de 12,6 minutes pour les modèles comparables. Son évaluation a produit 275 millions de jetons, ces unités de texte traitées par le modèle.
Pourquoi c’est important
La première place s’accompagne donc d’un compromis documenté entre résultat, durée de traitement et volume de texte généré. Le score concerne une configuration précise : il ne décrit pas nécessairement les performances obtenues avec les réglages par défaut.
Artificial Analysis précise également que son indice repose principalement sur des tâches textuelles en anglais. Les capacités multilingues, vocales et de raisonnement visuel font l’objet d’évaluations distinctes : cette première place ne constitue pas une supériorité établie dans tous les usages.
Sources
Sélection et relecture humaines, rédaction assistée par IA.